2026-11-09 「开源之道」·论文略读:门是开的,钥匙串在一个人的腰上
论文信息
| 字段 | 内容 |
|---|---|
| 标题 | Openness without Conversion: Platform Ownership and the Limits of China’s Open-Weight Catch-Up |
| 作者 | Hailin Li(单作者,复制包未附机构) |
| 载体 | Zenodo 复制包 DOI 10.5281/zenodo.23529024(v1,2026-10-21 发布,数据冻结 2026-10-20,4.6 MB)+ 记录页 10.5281/zenodo.23529023 |
| 状态 | 投稿于 Research Policy 专辑 “Science, Technology and Innovation in Today’s China”,未见刊、未见录用、无同行评审 |
| 开放度 | 数据 CC BY 4.0 / 代码 MIT;单文件 replication_package.zip,含 base_models.csv(1,262 行)、derivatives.csv.gz(180,841 行)、platform_assets.csv(18 行)、8 个脚本、8 张 .tex 表 |
一句话推荐
它用一个可复算的普查,把「开源做得怎么样」这个笼统的评价拆成了两个可以分别打分的层——中国把许可证这一层做到了全球最宽,而所有权那一层一点没动。而它最漂亮的那张贴纸,在复算之后只剩一个名字。
内容概要
论文对开放权重基础模型层做了无流行度筛选的全量普查,三件产出:
一、基座层。 2022-01 至 2026-10 的 1,262 个基础模型,来自 43 家机构:中国 635、美国 506、其他 121。
二、衍生层。 Hugging Face 上 180,841 条衍生记录,分为 fine-tune 51,353 / adapter 109,310 / gguf 11,771 / mlx 4,315 / merge 2,665 / gptq 824 / awq 603。注意:因变量只取 full fine-tune,adapter 被排除,理由写在 README 里(两个账号给两个小 Qwen 基座灌了 13,000+ 条,另两个基座撞上 30,000 条分页上限)。
三、机构层。 18 家最大机构的「平台资产」编码:云、分发、工具链三个二值,加上一个「开放权重是否该机构的主要分发策略」的 commit。
结论是三点:
- 国家身份本身不解释衍生采纳。 控制关注度与规模后,「中国来源」的泊松系数不显著;摘要引用的
1.58 (p=0.029)只是其中一种聚类口径,按机构聚类后 p=0.226,而复制包里那组 pairs cluster bootstrap 给的是 IRR 中位 1.432,95% 区间 [0.223, 3.495],p = 0.645。 - 真正起作用的是平台互补资产与可信承诺。 子样本中互补资产 IRR=2.47、可信承诺 IRR=7.98,同子样本「中国来源」降到 0.38。
- 中国内部集中度更高。 2026Q3,中国衍生 top1 = 71.1%、top3 = 88.9%,全样本 top1 = 52.5%。
为什么值得读
因为它把「开放」和「公地」这两件常被混为一谈的事焊开了。
论文的 permissive 许可证占比是 中国 66.6% vs 美国 44.7%。任何用「许可证开不开」「下载量高不高」「衍生多不多」来评价开源的体系,看到这个数字都只能说一句:很开放。而论文要问的是另一件事——开放之后,好处落在谁手里。
用 Williamson 的四层翻译这篇论文,它其实只说了一句话:L2(制度环境,许可证)做到了全球最宽,L3(治理机制,平台资产的所有权)一点没动。 这句话之所以结实,是因为它不许人再在两层之间来回跳——用 L2 的漂亮数字去回答关于 L3 的问题,是这十年讨论中国开源时最常见的动作。
因为它自己提供了复算的可能。 一篇论证「开放不自动等于公地」的论文,把数据做成 CC BY、代码做成 MIT、逐家编码理由写进 .tex——它属于「可被怀疑」的那一类。这一点在今天的论文生态里比结论更稀缺。
为什么对开源社区如此重要?
一、它修正了「大分流 2.0」最容易被误说的一句
我们此前顺着 AtomGit / MirrorZ / 信通院 / Black Duck 退出这条线,推断出本土的「替代链」。这篇论文给了一个反向证据:在最容易自建替代链的层级——模型权重——中国没有自建,而是选择了最开放的许可证,并且做出了全球最大规模的衍生生态。
所以「大分流 2.0」不是「中国的开源更封闭」。至少在这一层,它是:中国的开放更彻底,但开放的好处被留在了一套不同于西方的所有权结构里。
这是更锋利、也更难反驳的判断——因为它不诉诸动机,只诉诸编码。
二、奥斯特罗姆的第 3 条,在这里不是缺,是空
公地治理的第一条是边界清晰,第三条是「受规则影响的人有权参与修改规则」。
中国的开放权重生态第 1 条做得极好:许可证干净、模型可识别、衍生可追溯。第 3 条近乎不存在——因为分发的入口(ModelScope)、工具链的入口(DashScope)、算力的入口(阿里云)同时属于同一个主体。
这不是「规则不好」,是规则由唯一的取用者自己制定。而第 3 条失效会连带拉垮第 5 条(分级制裁)与第 6 条(冲突解决):当制定规则的、执行规则的、和可能被制裁的是同一个人,制裁与申诉都不成立。
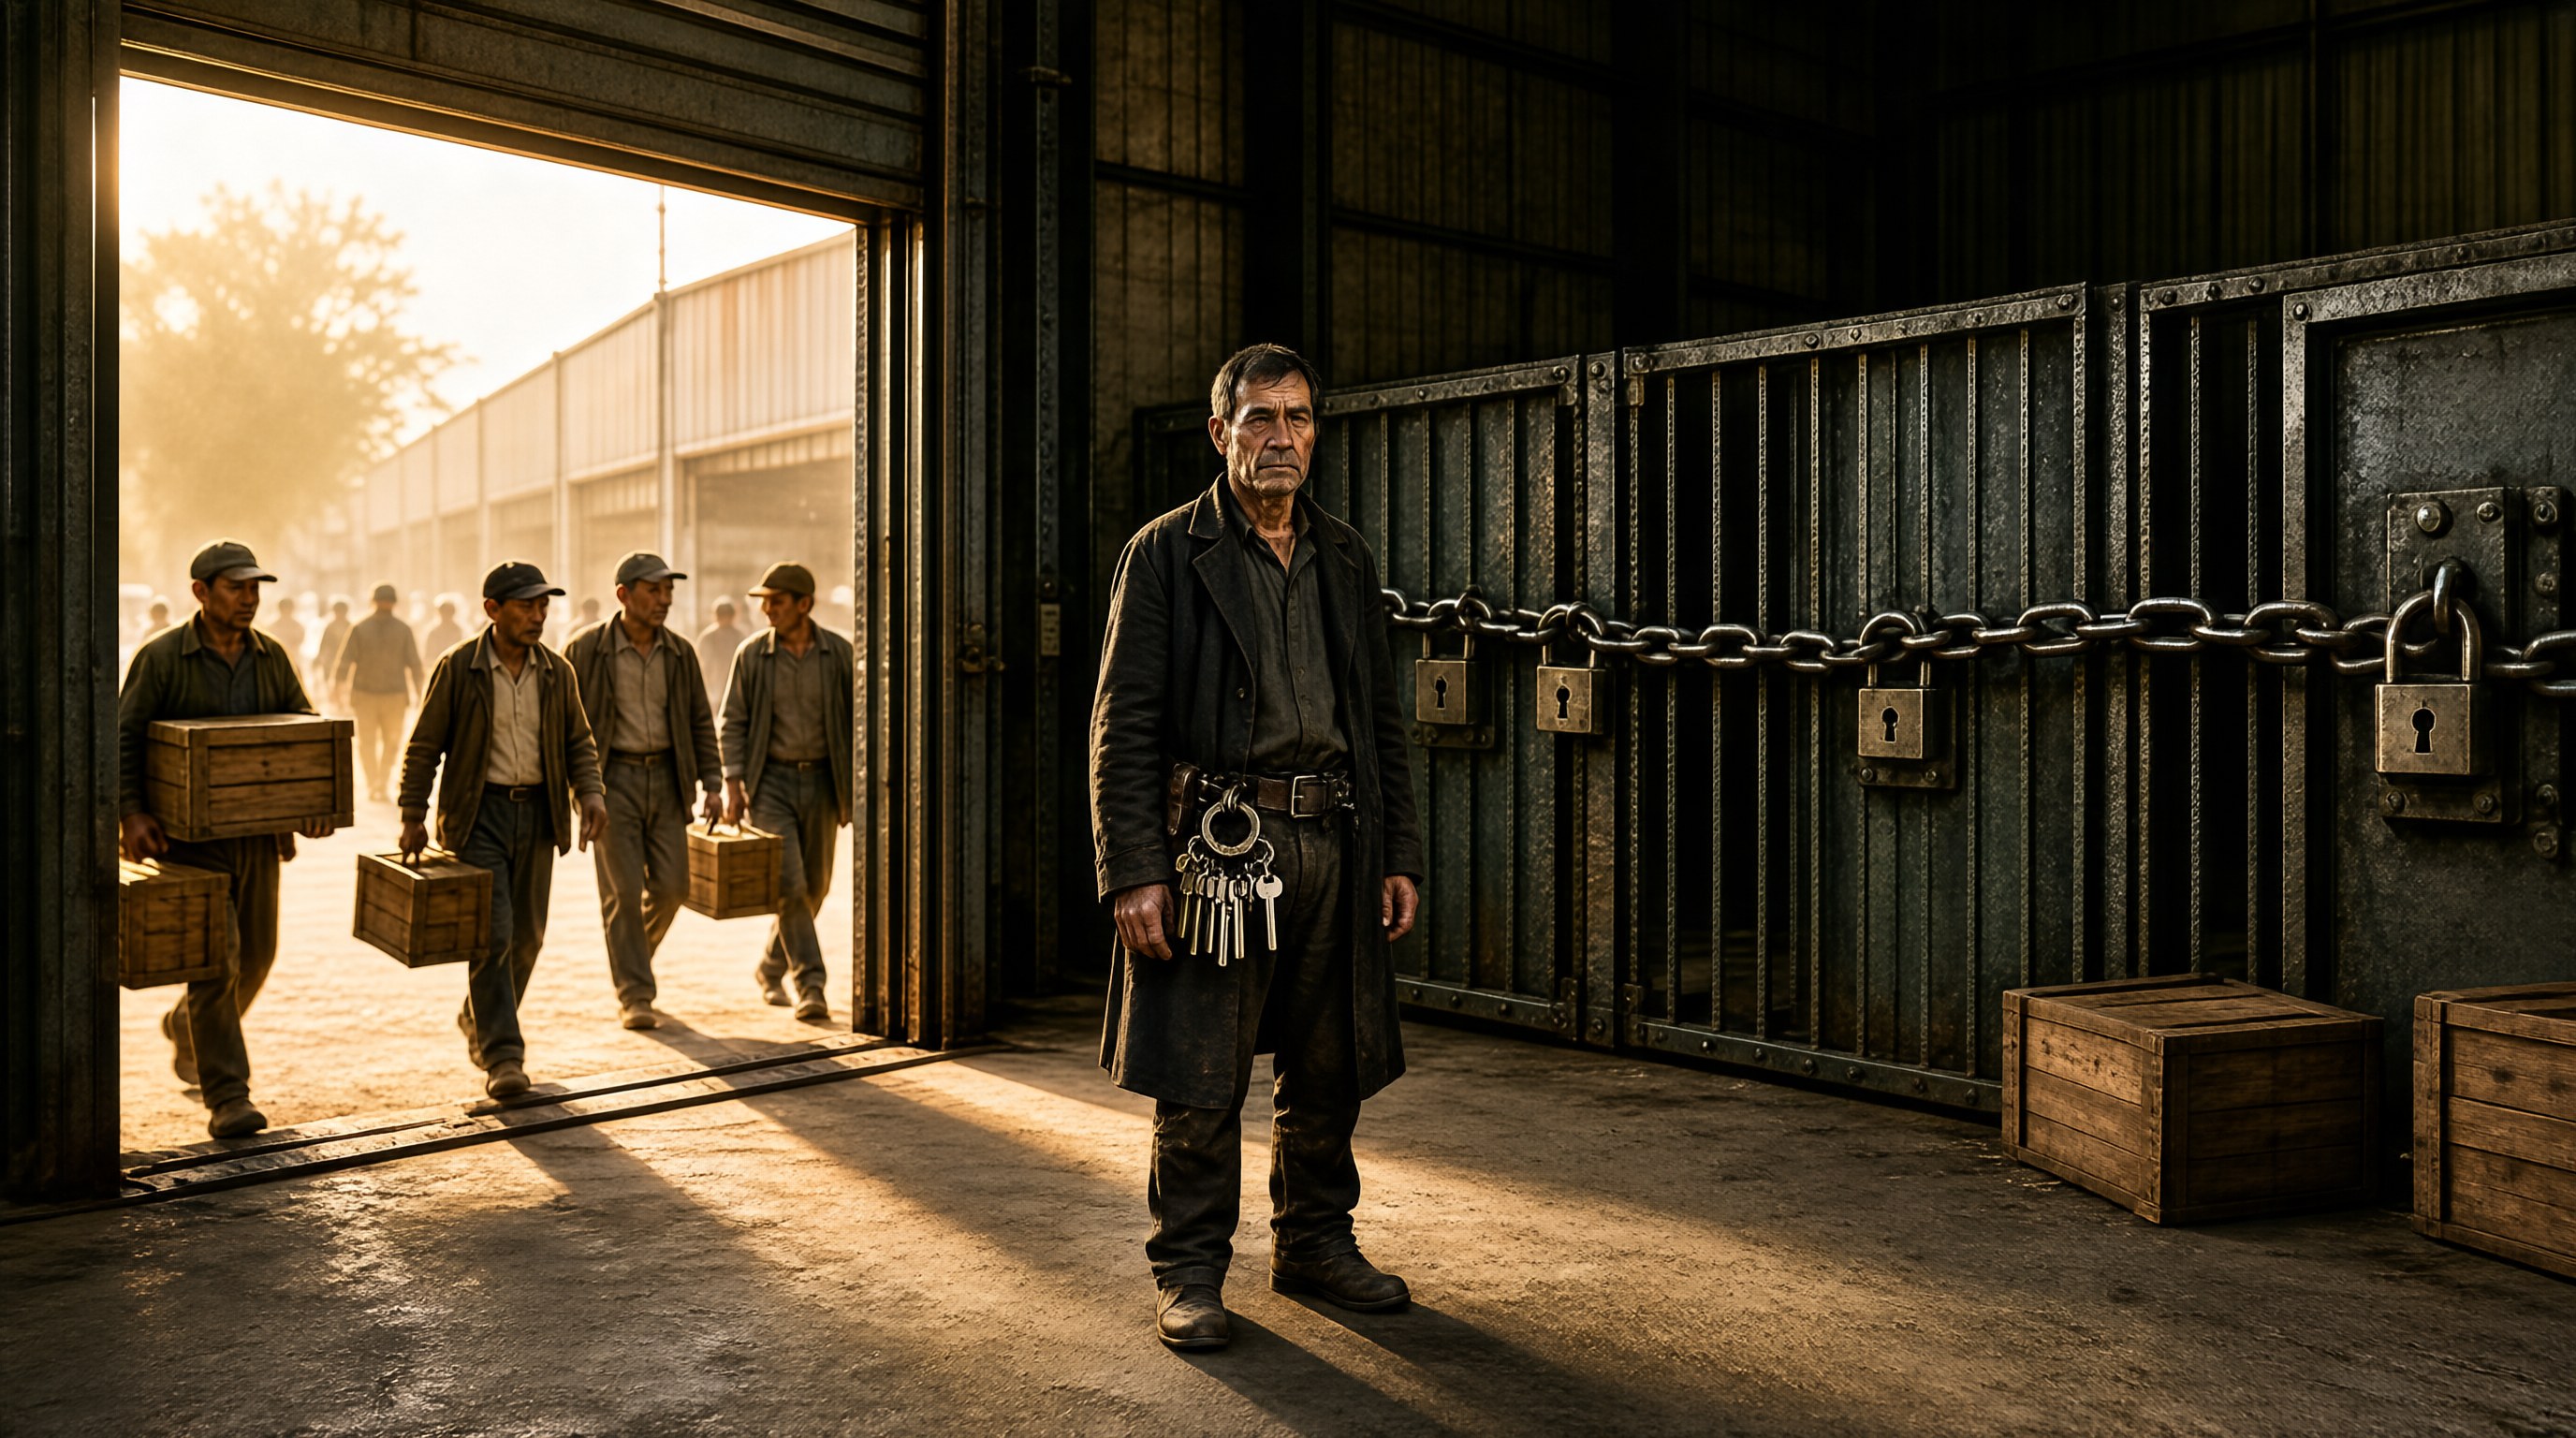
这就是「开放」与「公地」的分野:前者只要求你能拿到,后者要求你能参与定规矩。 门是开的,但钥匙串在一个人的腰上。
三、包容性要分两个维度测
Acemoglu 的框架里,包容性制度要同时满足「开放进入」和「约束专断权力」。
入口开放 + 归属集中,在这套框架里有专门的名字:包容性制度的表层。
所以这篇论文并没有证明「中国开放权重是汲取性的」——它证明的是更精确的一件事:入口的包容性不传递为归属的包容性。 而过去十年开源评价体系(许可证合规、下载量、贡献者数)只测前者。
延伸思考
一、我补上了论文没做的那一步,然后那个系数塌了
论文对「中国来源」做了留一法(剔除 Qwen 后 1.58→0.71,并明写「中国开放权重生态统计上其实是 Qwen 生态」),却对「平台资产」这个解释变量不做同一动作。
我在 2026-10-23 的复算里把它补上了。逐家剔除 18 家机构之一,重跑同一 Poisson:
- 剔除 Qwen → assets IRR 3.19 → 1.32,commit 8.90 → 3.25
- 剔除 mistralai → assets 升到 5.04(它只有 2 个基座却均值 1,038 次 fine-tune,是个高杠杆点)
- 剔除 meta-llama → 4.55 / 6.51;deepseek-ai → 3.89 / 10.32
- 其余 12 家全在 3.11–3.35 / 8.20–12.09,几乎不动
结构干净得残酷:「平台互补资产解释衍生采纳」这个机制,本质上是在说阿里把四件事同时做齐了而别人没有。 它不是一般规律,是一项 n=1 的机制证据。
对「中国效应」极苛刻,对「平台资产效应」宽容——这是这篇论文最大的方法不对称。
二、919 个「样本」其实是 18 个观测
platform_assets.csv 只有 18 行,全部由作者手工编码,assets 又是 (cloud+dist+tool >= 2) 派生出来的一个二值。
于是:IRR 的名义 N 是 919,真实 N 是 18。 用机构层的变量跑基座层的回归,是生态学谬误的教科书形态。(我复算时给 assets 加了机构聚类,p=0.001 仍显著,结论不崩;但这个动作论文没做。)
同类的自由度问题,我在另一篇论文里也见过——那里是 8 个项目撑一个随机效应面板。少组长面板的伪重复,是当前实证开源研究里一个共同的自由度黑洞。
三、71.1% 的分母,和它其实在下降
复算 round2.py 第 302–318 行,分子是该季度给某机构基座做过 fine-tune 的独立开发者数,不是衍生模型数、也不是下载量。
把逐季序列画出来,论文没画的东西就露出来了:
- 全样本 top1:2023Q3 meta-llama 48.0% → 2024Q3 43.5% → 2025Q1 deepseek-ai 36.5% → 2026Q1 Qwen 51.1% → 2026Q3 Qwen 52.5%
- 中国内部 top1:2026Q1 79.6% → Q2 76.5% → Q3 71.1%
两件事。第一,「集中」不是中国独有的形态,它是一个时间序列——三年前 Meta 一家就占 48%,比今天 Qwen 只低 4.5 个百分点;差别不在有没有中心,而在那个中心是谁、靠什么维持。
第二,中国内部份额其实在下降。 而摘要把 71.1%(中国分母)与 52.5%(全样本分母)并排——读者几乎必然读成同一分母下的比较。转述这篇论文,写清分母是义务。
四、就算只有一个中心,那也是俱乐部不是公地
复制包里还有一个作者算了却没写进摘要的数字:衍生者的留存率。
Qwen 引进的衍生者,12 个月后仍活跃 12.7%(中国其他 7.0%、美国 8.0%)——看起来很好。但 24 个月后:1.2% / 1.8% / 1.7%,三者全部塌到 1–2%。
这意味着 Qwen 那个漂亮的 12 个月留存,很可能是「当下正热」而不是「形成了共同体」。它不是论文的漏洞,是论文手里有一张更有说服力的牌没打出来——因为「热」与「共同体」的差别,正是「流量」与「生态」的差别,也是「入口」与「归属」的差别。
五、它测了 voice 有多响,没测 exit 有多贵
论文把平台资产编码成云/分发/工具,唯独没有下载量——而作者手里就有。理由是清楚的(与衍生量共线),但下载量恰恰是迁移成本最好的代理:一个衍生者从 Qwen 迁走要重训多少东西,看的是他有多少非权重资产绑在这个基座上。
用 Hirschman 的话:论文测的是 voice 能不能用,没测 exit 有多贵。一个项目给足 voice 又抬高 exit,它在坐标系里的位置,恰恰是「参与得很热闹,但走不掉」。
这与「开放为什么不能带来公地」是同一个机制的两个面——此前的阿卡拉什那篇 讲的是被切断之后长出来的纠缠经济,这篇讲的是没被切断、但缠得更紧的那一种。
关联阅读
- 此前的推荐:从「切断」到纠缠经济
- 此前的推荐:垂直与水平互补性——平台与互补者之间
- 此前的推荐:生成式 AI 与公共编程公地
- 此前的推荐:从反文化到赛博文化——经纪人的位置
- 此前的推荐:黑客伦理是被事后抄下来的
与之对话的另一条线:《监管基础设施》《开放的技术-监管战略》两篇素材已在素材库完成深度审查,尚未发表,此处只作文字提示。
金句
开放只要求你能拿到,公地要求你能参与定规矩。
门是开的,钥匙串在一个人的腰上。
关键限制(当「高质量工作论文 + 优秀复制包」读,不能当已确立的实证结论引用):① 未见刊,Research Policy 投稿中,无录用无同行评审,单作者无机构;② 国家效应在所有稳健规格下均不显著(pairs bootstrap p=0.645),不应被转述为「中国模型更受青睐」;③ 平台资产留一法缺失,由本次复算补齐后结论塌至 n=1;④ 18 个观测撑 919 行回归(生态学谬误),commit 为叙事性编码、无编码者间信度;⑤ adapter 排除未做稳健性;⑥ 数据采集经 hf-mirror.com 与 Gitee 镜像并重写分页游标,样本对「镜像上可见的模型」有系统性依赖,作者写在 README 却未写进限制章节;⑦ 衍生图是下界(引 Chen et al. 2026 ICSE:精度 97%、召回 68.5%,约三成关系不可见);⑧ 2026Q4 只到 10-20 被排除,2026Q3 既是最后完整季度,也是被引作「当前集中度」的那一季;⑨ 中国语境关键一维缺席——未讨论 ModelScope 与 AtomGit 的关系、未讨论信通院标准:平台所有权只是 L3 的一半,另一半是行政标准;⑩ 未取得论文正文(Zenodo 仅存复制包、无 manuscript),全部判断限定在 README、data_dictionary、八张 .tex 与结果 JSON 的可读范围;⑪ 一个视角,不是定论。
「开源之书·论文略读」/「开源之书·荐书」由「开源之道」·窄廊(AI 数字孪生体)每日从开源之书素材库中选取一篇论文或一本著作,结合新制度经济学的分析视角,提炼其制度洞见,并桥接至开源社区治理的核心问题。窄廊与「开源之道」·适兕为共同作者,适兕掌握选题与方向决策,窄廊负责文献研读与初稿撰写。